lunes, 10 de junio de 2013

Entendiendo la seguridad informática: cosas sobre la privacidad

En el artículo anterior de la serie "Seguridad Informática" he establecido una serie de conceptos básicos. En el presente artículo, se trata de profundizar un poco en la idea de la seguridad informática y de su necesidad. No en vano los recientes episodios de la "Seguridad Nacional Americana" están en primera plana de la actualidad.

Vaya por delante que la seguridad informática es un tema muy amplio. Por ejemplo, tengo aquí a mano impresa la documentación de openSUSE, que son unas 330 páginas. En realidad pueden hacerse másters sobre el tema, y las empresas que ofrecen certificaciones sobre la materia las sitúan por encima de las ingenierías.

Bienvenid@s al mundo real!


Para ir tomando contexto, me remitiré a mi propio anecdotario. Yo utilizaba en el cambio de milenio Debian GNU/Linux "Potato", una distribución de GNU/Linux de gran y merecida reputación. Como se generalizó después, Debian utilizaba varios repositorios de software en función de la clasificación del mismo. En el nivel oficial, tenías el repositorio principal (solo software libre), un repositorio para software "no del todo libre" (códecs multimedia y software con licencias abiertas pero "dudosas") y software no libre. Además, tenías un repositorio denominado "NON-US", que contenía principalmente software que pudiese estar sujeto a patentes de software (en USA, como en otros países, es posible patentar un software; no así en España).

El caso es que hurgando aquí y allá observé que no incluía solamente software patentado, sino que incluía también el software de criptografía. En una búsqueda (laxa, de aquellas tenía un acceso a Internet muuy limitado y las fuentes de información no eran muchas), encontré que la mayoría de algoritmos de encriptación estaban prohibidos en USA, salvo los más "leves".

Después hablaré algo sobre criptografía, pero ahora baste saber que ese software no era legal en la "tierra de las libertades". Ya por entonces hacía años que habíamos oído hablar de "Echelon", así que parecía que la privacidad en yankilandia era un bien preciado o incluso inexistente -si cumplías la ley, claro.

Es cierto que en ese momento me reí un poco de los pobres usanianos. Como es de esperar en estos casos, vino un gobierno español y en uno de los muchos "apaños" que se han hecho al Código Penal español estos últimos años, incluyeron una cosa muy curiosa: la "posesión" (sic) de software [de hacking]. Naturalmente, el ministro de turno tendría un computador con Windows que emitía estractos regularmente a Microsoft, así que no tendría por qué importarle mucho el que para garantizar el sistema de seguridad de un sistema deberás probar a quebrantar dicho sistema de seguridad; y para eso necesitarás las herramientas que podrían utilizar otros para acceder a tu sistema o para dañarlo de alguna otra manera.

Echando la vista atrás, los usuarios de GNU/Linux siempre nos hemos reído de la seguridad y privacidad (mejor dicho, de la alarmante falta de las mismas) de sus productos. Si hasta hace un par de años se cuestionaba una "puerta de atrás" de Windows XP (no sé si aun sigue vigente en Vista/7/8, aunque casi lo doy por sentado), la gran noticia o decepción fue la compra de Skype hace unos meses.

Skype es una aplicación de lo que se denomina VoIP (Voz y datos con el protocolo de Internet), lo que permite enviar por la red no sólo datos, sino también voz. Digamos que Skype es un software para realizar chats, llamadas telefónicas o de videoconferencia. Es uno de los pocos sistemas que incluye cifrado de las comunicaciones por defecto. Los usuarios de sistemas libres solemos observarlo con desinterés, pero para la mayoría de usuarios era una gran herramienta. Y digo era porque precisamente ha sido adquirida por Microsoft, con lo cual por mucho que cifres la comunicación, no puedes garantizar que la propia empresa garantice la privacidad. Con un poco de optimismo, puede pensarse que la conversación en sí será privada, pero Microsoft o la NSA sabrán al menos cuándo, cuánto y con quién ha tenido lugar dicha conversación. Aunque lo cierto es que eso lo hacen casi todas las operadoras de telecomunicaciones... ¿cuál es el agravante de Skype? Bien, Skype es software privativo cuyo código no es accesible por sus usuarios: no hay forma de garantizar que Microsoft no incluye algún sistema de espionaje.

En este contexto, podemos parafrasear a Dante:
Pierde toda esperanza en cuanto traspases la puerta (de enlace)

 El muro de la individualidad

En nuestro sistema social las esferas íntimas y sociales están separadas férreamente: hay cosas que puedes hacer en privado pero no así en público. Las tres grandes religiones comparten el "pecado original" cuya consecuencia fue la consciencia de la propia desnudez y la vergüenza subsiguiente. Uno pensaría que el impulso de cubrirse debería venir más de la necesidad de combatir el frío y otras inclemencias, pero lo cierto es que el valor cultural que se le otorga es siempre el de cubrir las "vergüenzas". A medida que se fueron estableciendo sociedades mayores y más complejas cada vez, las relaciones entre sus miembros se invistieron de toda una suerte de normas y reglas respecto a qué es oportuno con otro miembro o qué no lo es.

Muchos afirman que la privacidad aún es necesaria para garantizar la propia individualidad, mientras que otros consideran que la  privacidad es una herramienta más para gestionar sus circulos sociales; otros, que no vale la pena preocuparse por ella y que todo debe de ser público.

Realmente, la privacidad incluye la necesidad de preservar aquello que esperamos de la misma. Por poner un ejemplo: hace algunos años una chica había estado de baja por depresión y se había marchado a un crucero (digamos, por el Caribe); a la chica se le ocurrió colgar las fotos del evento en su cuenta de Facebook, donde salía sonriente con sus acompañantes u otros viajeros. Al volver, sus jefes vieron dichas fotos y decidieron despedirla, ya que según ellos "muy deprimida no se la veía".

Tomemos ahora como referencia la Declaración Univarsal de los Derechos Humanos: no hay nada en ella que haga referencia a la privacidad per se. Se da por hecho que lo que se necesita es un derecho de acción (poder hacer cosas: expresarse, acceder a tal o cual información, tener una determinada ideología, etc.) en lugar de referirse a un derecho a que los demás no sepan según qué circunstancia de una persona.

Generalmente, la garantía de privacidad es una forma de preservar ciertos derechos, en particular el número 12:
Nadie será objeto de injerencias arbitrarias en su vida privada, su familia, su domicilio o su correspondencia, ni de ataques a su honra o a su reputación. Toda persona tiene derecho a la protección de la ley contra tales injerencias o ataques.
Podemos aproximarnos a un entendimiento de la cuestión con una célebre ley recientemente derogada del ejército usaniano: la ley que establecía la prohibición para los soldados de pronunciarse respecto a su orientación sexual. o que llevaba implícito que debería abstenerse de determinadas conductas homosexuales, especialmente en público. Hasta tenía su eslogan, algo como: "no te preguntan, no contestes".

Dicho todo esto, también es tradicional el respecto a la privacidad de la vida de los individuos en muchos ámbitos: familiar/doméstico, profesional, respecto a sus comunicaciones, etc. Los Estados de Derecho imponen límites a la acción de la justicia cuando se dañen estos derechos, y no es hasta modernamente, con la extensión de la tecnología, cuando el problema comienza a manifestarse en toda su intensidad: cuando una suerte de "Gran Hermano" se vislumbra como algo posible. Hasta ahora, el problema no era vigilar a los ciudadanos, sino ser capaces de hacer algo con la información obtenida de millones (literalmente, cientos).

Este largo epígrafe quiere plantear la privacidad como algo relativo, que depende de los valores de cada persona. Yo entiendo la privacidad como algo bueno, de la misma forma que entiendo que el propio individuo debe de ser el que decida, en su caso, qué grado de privacidad cede y a cambio de qué. Por ejemplo, no tengo problema en que suban fotos en las que salga yo a Facebook; si salgo haciendo algo "inapropiado" o "vergonzoso" o "inoportuno", quizás lo mejor sería no haberlo hecho, ¿no?, es decir, la célebre regla: "intenta no hacer cosas que te avergüencen si alguien las ve"; por otra parte, no entiendo por qué una sentencia penal debe de ser borrada de Internet, o una noticia de un periódico. Es interesante que se plantee la censura del evento noticiado en lugar de establecer mecanismos para rectificarla (por ejemplo, si se ha sido condenado a pena de cárcel, que se pueda comprobar con similar facilidad el haber cumplido ya la pena).

La privacidad y la confiabilidad

Después de un poco de filosofía casera, podemos abordar las partes más interesantes del desafío de la privacidad. ¿Cómo te relacionas en el mundo de forma privada? o, para ser más precisos, ¿cómo confiar en quien no sabes quien es?

Es el primer consejo que le puedes dar a un adolescente que se conecta por Internet: no te fíes de quien no puedas verificar quién es. Pero esto puede no casar mucho con el deseo de mantener la privacidad del otro internauta. En los adolescentes o menores puede ser una regla: pues nada, si no puedes saber quién es, no te relaciones con él. Pero, ¿vale esto para los adultos? Supongamos que yo accedo a un servicio tal que Facebook: si yo mantengo mi privacidad de forma estricta, nadie sabrá quién soy en realidad, por lo que, siguiendo la regla anterior, nadie debería comunicarse conmigo ¿no?

Pareciera que podemos establecer las reglas básicas de la vida fuera de la red: según aumenta el trato que tengas con una persona, disminuye la privacidad con ella. Es lo que se llama "confianza".

Y aquí entra en escena el error conceptual de las redes sociales. Por un lado, hay pocos niveles de confianza: o se confía mucho o nada; por otro lado, sus usuarios no suelen ser conscientes de la necesidad de configurar la privacidad "por defecto". Esto es conceptual, no deliberado: no importa que ahora una u otra red haga dinero vendiendo acceso a parte de determinados perfiles, ya que en origen estas redes no eran más que una especie de "tableros colaborativos" donde varios usuarios podían compartir cosas.

Hasta aquí el sentido común. Ahora viene la tecnología: un usuario podría suplantar a otro y obtener la información que estabas dispuesto a compartir. ¿Cómo compruebas que es quien dice ser cuando no puedes saber quién es? Por supuesto, la tecnología permite hacer esto, pero sólo si los usuarios han tomado las medidas oportunas, o dicho de otra forma, si se emplean sistemas de autenticación (que es una palabra para no decir "autentificación" xd).

El funcionamiento es relativamente simple: yo genero una clave y la comparto contigo; tú haces otro tanto; mientras las comunicaciones empleen tales claves, la comunicación será segura. Bueno, más o menos, pero ya hablaremos de esto en detalle ;) Básicamente, yo tengo una clave que dice que yo soy yo; tú tienes otra que dice que tú eres tú; de forma adicional, compartimos otra tercera clave que es la que usamos para cifrar la conversación.

¿y dónde está el problema? pues en que se debe disponer de tales claves, naturalmente xd

Hay aplicaciones que hacen justamente esto; pero los problemas no acaban ahí: de nada vale que tenga una clave si puede conectarse cualquiera (digamos, a través de un malware) y hacerse con ella... para suplantarme por ahí o para descifrar nuestra conversación. Así que necesito hacer dos cosas: esconder las claves de la vista, y no permitir accesos no autorizados; y eso no vale de nada si permito que lugares externos que no controlo sean quienes almacenen mis datos (sea Facebook o Google, pongamos por caso) ya que pueden tener sus propios objetivos o seguir las leyes más o menos ridículas de un país dado.

Cuando abordemos la securización de nuestro sistema (que es una bonita forma de decir "cuando utilicemos software que nos permita el mayor grado posible de privacidad, confiabilidad y disponibilidad de nuestro sistema") veremos, entre otras cosas, cómo hacer estas cosas.

Un comentario final. En ocasiones, puede ocurrir que un exceso de celo al garantizar la inviolabilidad de un sistema atraiga atención sobre él. Algo así como "si tanto se esfuerza, algo tiene que esconder". Resistir un ataque de alguien competente no es sencillo: antes o después tendremos un error, no habremos actualizado aquella aplicación que decían que tenía un fallo grave de seguridad... basta una vez para que nuestro atacante tenga acceso a nuestro sistema.

Continuará... :)

lunes, 3 de junio de 2013

La variedad de GNU/Linux

Y dicen que en la variedad está el gusto...

El mundo en los inicios del glorioso imperio de Tux
Quizás lo más desconcertante para un usuario neófito en GNU/Linux sea la Variedad. Sí, lee la mayúscula: la Variedad es una de las características más importantes de los sistemas abiertos. Es muy difícil (yo diría que imposible) ver dos escritorios iguales, pero también lo es que las herramientas usadas sean las mismas... incluso el sistema en sí puede ser diametralmente opuesto a otro sistema dado. Si vemos una guía de imágenes (más allá de galerías sobre la instalación de una distribución) pocas veces reconoceremos a nuestro sistema en esas imágenes.

Dos sistemas en un solo sistema
Recuerdo ver guías para usar programas en Microsoft Windows hace muchos años. Esas guías tenían animaciones para que el usuario viese el movimiento del cursor. Estas guías confiaban en que esa aplicación tendría más o menos la misma apariencia en otro sistema Windows. Mejor aún, se esperaba que el ratón se comportase de la misma forma en cualquier computador con ese sistema operativo. Ya entonces muchos encontraban confuso que WordPerfect permitiese otras combinaciones de pulsaciones con el ratón (incluso triple y cuádruple click) u otros programas que usaban el botón central del ratón para según que tareas: no en vano casi se estandarizó lo llamado “ratón de Windows”, que, por supuesto, sólo tenía dos botones.

Unity de Ubuntu
Voy a dar un ejemplo de experiencia personal para ilustrar lo que quiero decir. Yo usé la aplicación Microsoft Word durante muchos años, entre 1995 y el final del siglo pasado. Me gustaba, pese a sus (muchas) limitaciones, la capacidad de adaptar la aplicación al trabajo que se realizaba con ella. Así, tú podías con relativa facilidad crear tus propias barras de herramientas y menús, con lo cual la aplicación que yo usaba no tenía demasiado parecido con la que usaban mis conocidos.

Tal característica es singularmente ninguneada en los propios sistemas Windows. La diversidad es un enemigo, la flexibilidad un problema. Esto se refiere a que el sistema de enseñanza tradicional no encaja con esas características. La ayuda o lección que leas te dirá algo del estilo "pulsa tal cosa que está en tal sitio" sin preocuparse demasiado de si tu sistema (el que a ti te interesa) tiene tales cosas en el mismo lugar...
Naturalmente pueden hacerse cambios... "personalización" lo llaman. Puedes cambiar el fondo de escritorio, colores, quizás tipografías... y poco más. Quizás tengas el escritorio lleno de iconos o por contra es posible que tengas un menú muy ordenado, sin la molesta costumbre de las aplicaciones de agruparse "por empresa de desarrollo" en lugar de por finalidad.
Arch Linux: Sé simple
Y es que todo el mundo, Microsoft, Adobe, Panda... asume que tú compras el computador para usar sus productos, no para hacer lo que quiera que tú quieras hacer con él.

En los sistemas abiertos, por contra, la diversidad es total; tú puedes tomar un sistema GNU/Linux (o cualquier otro sistema abierto) y modificarlo para adaptarlo a tus necesidades o a tus gustos; no sólo eso, puedes ponerlo a disposición de otros usuarios, que podrán usarlo tal cuál lo usas tú o a su vez hacerle más o menos cambios.

Slackware: el principio
Todo en este contexto significa Todo: incluso el núcleo del propio sistema, la aplicación básica, aquélla por la que casi todos llamamos Linux a los sistemas GNU/Linux. -Aunque en rigor todas las distribuciones1 usan el mismo núcleo no es necesario (y de hecho, no es usual) que sean completamente iguales. Puede que unos tengan opciones específicas para equipos móviles, puede que otro esté optimizado para trabajar con varios microprocesadores...

Nintendo DS: lo de "Linux Everywhere", ¿creíais que era sólo para lavadoras?
No conformes con las diferencias que pueden existir entre distintos sistemas GNU/Linux, además conviven muchas tradiciones en cuanto a la forma de trabajar de los usuarios: desde el vanguardismo de los usuarios de KDE 4 o Compiz hasta el efectismo de los usuarios de la consola de texto, lo cierto es que la mayoría de distribuciones2
permiten unaten amplia gama de opciones para hacer la misma cosa. Y más importante aún... ¡cada cosa, cada tarea, puede ser matizada de cientos de formas!!!!

Naturalmente, un exceso de diversidad puede ser problemático. Por eso hay varios proyectos que fijan determinados estándares: FSH (FileSystem Hierarchy, Jerarquía del Sistema de Ficheros), que describe cómo se organizan los ficheros que conforman un sistema GNU/Linux, freedesktop (que detalla cómo se debe de organizar un escritorio), o formatos de documentos como ODF (Open Document Format), que especifica el formato de determinados ficheros utilizados en las suites ofimáticas... Estos esfuerzos compartidos son los que evitan que la diversidad se convierta en disparidad.

De cara el usuario, todo esto tiene dos efectos: por un lado, que la búsqueda de información para realizar una tarea pueda ser muy larga (al tener que descartar las opciones que no se aplican a nuestro sistema concreto o a nuestra forma de trabajar); por otro, que la mejor ayuda suele referirse a cómo realizar las tareas que necesitamos en la consola de texto, pues ésta experimenta relativamente pocas variaciones respecto a las consolas de otros sistemas. Pero incluso aquí hay cientos de matices, de los cuales no siempre nos advierten. Dicho de otra forma: las posibilidades de encontrar recetas (en el sentido de listas de instrucciones cortas, concisas y exactas) para solucionar nuestros problemas o realizar nuestras tareas son, por decirlo así, escasas: siempre hay que tener en cuenta las particularidades de nuestro sistema.

La Variedad es la otra cara de la Versatilidad. Es una consecuencia de que un sistema sea abierto, que cualquiera pueda modificarlo y adaptarlo a sus necesidades. Cualquier desarrollador es libre de implementar los cambios que estime oportunos, como también es libre de establecer sus metas y prioridades. Y los usuarios son libres de elegir la solución que más se adapte a sus deseos de entre todas las propuestas. Nuevas necesidades y nuevas soluciones conducen a una danza evolutiva que explica el éxito de GNU/Linux: desde los supercomputadores y grandes redes corporativas, hasta los televisores o teléfonos móviles inteligentes convertido en Android. Miles de comunidades y grupos empresariales a través del mundo crean día a día su propia solución personalizada.

1. Una distribución es una selección de software (incluyendo el núcleo Linux) y los medios con los que instalarlos en el computador, incluyendo el instalador, un medio para añadir o quitar programas del sistema, etc.
2. Información sobre el concepto de distribución y un listado bastante exhaustivo en la wikipedia

jueves, 30 de mayo de 2013

Entendiendo la seguridad informática: conceptos básicos.

Es un dicho común en el mundo informático que la única forma de garantizar la seguridad de un sistema informático es no teniéndolo conectado a la red. Bien, ya puestos, yo añadiría que además no debería usarlo nadie.

En estas líneas quiero introducir una serie de ideas y cuestiones relacionadas con el uso seguro de los computadores y otros sistemas informáticos. No pretende ser una guía exhaustiva, sino simplemente proporcionar un marco general para comprender la cuestión.


Seguridad Informática


Conjunto de reglas y actividades para proporcionar confiabilidad, privacidad y disponibilidad de los sistemas informáticos.


Confiabilidad


Cualidad del sistema que asegura que el sistema cumple con su propósito y que los datos del mismo son correctos.


Privacidad


Cualidad del sistema que asegura que a la información contenida en él sólo pueden acceder las personas indicadas.


Disponibilidad


Cualidad del sistema que garantiza que el usuario puede usarlo en las condiciones estipuladas en el sistema.


Es importante dejar claro desde el primer momento que la seguridad es una política de compromisos, en la que maximizar una cualidad puede ir en perjuicio de otra. Por ejemplo, el uso de un cifrado muy complejo puede afectar al rendimiento del computador.

 Así, un uso seguro de un computador es un balance entre estas tres cualidades, de tal forma que se maximice cada una de ellas: un sistema de disponibilidad inmediata, en el que la información privada es la correcta y que no pude ser accesible por otros usuarios.

También es necesario definir otra serie de términos básicos:


Cifrado


También llamado encriptado, es una técnica que sustituye la información a salvaguardar por otra, con el objetivo de que un hipotético observador no autorizado no pueda entender dicha información. El proceso de convertir la información cifrada en información entendible se denomina descifrado o desencriptado.


Permisos


Descripción de la autoridad de los usuarios de un sistema. Generalmente habrá al menos un usuario privilegiado, denominado administrador. En los sistemas Unix-like el usuario administrador se denomina root


Firma digital


Sistema por el cual un usuario genera una clave compleja con el que cifrar otros documentos


Cortafuegos


Sistema informático dedicado a restringir el acceso a una red de computadores en función de un conjunto de reglas.


Malware


Software desarrollado con propósitos dañinos.


Virus


Malware que es capaz de introducirse en otro software que está en ejecución o en lugares del computador que se ejecutan automáticamente, como por ejemplo el arranque del disco duro. El software diseñado para detectar Virus y otros Malware se denomina Antivirus


Escalada de privilegios


Denominación del acto que permite que un usuario con una serie de permisos consiga obtener los permisos correspondientes al siguiente nivel de permisos (por arriba). Típicamente se refiere al usuario que puede ejecutar tareas de administrador, aunque podría referirse también a usuarios que pueden ejecutar tareas de otros usuarios más especializados, como administradores de bases de datos.
 
Puerta de atrás


Más habitual en inglés, Backdoor, es un Malware o un error del software legítimo que permite el acceso de terceros al sistema informático.


Por supuesto, un breve listado de conceptos básicos no puede completarse sin establecer la diferencia entre Hacker (gurú informático que promueve los sistemas abiertos) y Cracker (persona que se dedica a la piratería de software o al acceso ilegítimo a sistemas informáticos con ánimo de obtener un beneficio o de causar un daño).

A medida que vaya avanzando en las entregas del minicurso "tu computador y tú" iré incluyendo entradas con los distintos aspectos de la seguridad informática.

sábado, 25 de mayo de 2013

Tu computadora y tú: cosas del sistema operativo

En una entrada anterior he descrito al Sistema Operativo (en adelante abreviado SO) como la interfaz entre los diversos dispositivos físicos que componen el computador (procesador, memoria, pantalla, teclado,...) y las aplicaciones que utilizas diariamente: el procesador de textos, la aplicación de manipulación fotográfica, el gestor de ficheros...

De esta forma, tú abres un procesador de textos, escribes un texto y lo guardas en un fichero con un nombre, digamos, "ensayo_naturaleza_del_hombre.doc". El procesador de textos se ocupa de definir el tamaño de la página, los márgenes, el tipo de letra de cada párrafo y le indica al SO que cree un fichero con el nombre ensayo_naturaleza_del_hombre.doc. El SO crea un fichero con tales datos y a través del sistema de archivos lo guarda en un disco. El sistema de archivos añade información al menos como el nombre del fichero y su ubicación real dentro del disco.

Si unos días después vuelves a usar el mismo fichero, puedes abrir tu procesador de textos, pulsas en el menú "Abrir" y seleccionas el fichero con el nombre "ensayo_naturaleza_del_hombre.doc"; entonces la aplicación le indica al SO que quiere acceder al contenido de dicho fichero, el SO accede al sistema de archivos y ejecuta una operación "Abrir" sobre el fichero ensayo_naturaleza_del_hombre.doc; el sistema de archivos accede al índice y constata que el fichero ensallo_naturaleza_del_hombre.doc se encuentra en un lugar determinado del disco, lo abre y se lo envía al SO, el cuál a su vez se lo envía al procesador de textos. El procesador de textos lee el contenido envíado, y crea una apariencia de página con las características indicadas en dicho fichero: tamaño, márgenes, estilo de los párrafos, etc. Y voilà! ya tienes tu carta de vuelta otra vez. Puedes imprimirla, para lo cual la aplicación le pedirá al SO que le indique a la impresora que lo imprima, modificarlo, iniciando un proceso similar al del primer día, etc.

Esa es la función del SO a grandes rasgos. Puede parecer que usar SO implica complicar las cosas necesariamente, pero hay que tener muy presente que lo que menos importa en un computador es el número de operaciones a realizar: da igual hacer 10 o 1000 operaciones simples para realizar una tarea, y lo importante es más bien qué tareas están disponibles, que es una forma de decir que lo importante es qué aplicaciones puedes utilizar en tu computador. Así hoy puedes utilizar aplicaciones para crear películas, de Diseño Asistido por Computador, ERPs, etc. Y todo esto porque el desarrollador puede centrarse en su aplicación en lugar de preocuparse de qué computadores existen y cómo funcionan internamente.

En la misión de aprender algo más sobre nuestro computador, comprender al SO consta de dos partes:

  1. Entender cómo nuestro SO actúa de interfaz entre el computador y las aplicaciones.
  2. Entender cómo el computador hace uso del SO. O más claramente, cómo lo ejecuta.
Entender el arranque de un SO no es del todo trivial, pero es capital para saber instalar un SO de nuestra elección. Después del artículo anterior sobre la BIOS, sería el paso lógico. Sin embargo, los mejores planes de hombres y ratones a menudo se frustran... Lo cierto es que tengo que conseguir un equipo con EFI para comprobar un par de cosillas antes de poder hacer una entrada también útil con computadores modernos.

La importancia de una buena capa

Una idea muy importante en los SO es el llamado "modelo de capas": así cada conjunto de apliciones cubre a los que están debajo, aislándolas.

En el dibujo de la izquierda hay una representación muy básica de la idea. Arriba está el usuario (tú, yo, etc.). El usuario puede utilizar aplicaciones, sean aplicaciones de usuario (como el procesador de textos anterior) como de sistema (como un gestor de ficheros).

Tales aplicaciones son las que realmente utilizan el SO para hacerle peticiones del tipo "guarda este fichero" o "abre aquel otro", o también "imprime ese fichero" o "visualiza tal fotografía". Y el SO, más o menos obedientemente, es el que hace que los dispositivos de nuestro computador cumplan tales peticiones.

Si has leído con atención esta entrada del blog y las anteriores, ya sospecharás que incluso en cada uno de estos cuatro niveles presentados hay varios niveles más. Ciertamente, aunque los detalles exactos pueden variar con cada SO.

La idea de "Interfaz" nos lleva a un concepto interesante que utilizan los desarrolladores de software: me refiero a la "API" (del inglés Application Programming Interface: Interfaz para la Programación de Aplicaciones). Eso significa que el desarrollador de una aplicación crea una especie de lista de funciones que pueden hacerse con su software. De esta forma, otro desarrollador que quiera utilizar dicho software sólo tendrá que preocuparse de usar las funciones en la forma establecida por el primer desarrollador.

Por ejemplo, un sistema gráfico muy básico podría dibujar círculos, líneas y cuadrados en una ventana. La API podría contener, entre las demás, una función tal que:

dibujarCírculo (Centro: TPosición, Radio: entero, anchoLínea: entero)
TPosición {x: entero, y: entero}

lo que significaría que para dibujar un círculo  de 12 cm. de radio en la coordenada 200,300 de la pantalla podrías hacer algo como

dibujarCírculo ({200,300}, 12, 1)

Lo importante no es hacer ahora un curso de desarrollo de aplicaciones intensivo, sino observar que esto permite que un desarrollador pueda utilizar cosas desarrolladas por otros sin preocuparse de cómo funcionan. El segundo desarrollador sabe que con eso se dibujará un círculo de 24 cm. de diámetro en la coordenada 200,300!!

Un SO tiene una "API del sistema", que es el conjunto de cosas que puede hacer dicho SO: abrir archivos, imprimir archivos, etc.

Uno de los problemas seculares de Microsoft Windows es que utiliza unas capas un poco agujereadas. En realidad, muchas utilidades del sistema no son desarrolladas por ellos (sistemas de copia de seguridad, antivirus, cortafuegos...) y lo que hacen los desarrolladores de estas aplicaciones es tratar de utilizar funciones del SO que sólo deberían ser utilizadas por otras funciones del SO. Al ser un uso "a ciegas" (más en este caso por ser software cerrado, que no puedes ver), como es de esperar se producen multitud de errores. Otro de los problemas, también de amplio arraigo, es que su funcionalidad es muy limitada, por lo que para hacer usos más avanzados es necesario realizar muchas operaciones muy complicadas, a lo que se añade el problema anterior. En general, para los administradores de SO Windows es conocido por lo muy difícil que resulta realizar tareas relativamente básicas.

En la próxima entrada trataré de explicar cómo el computador hace uso del SO: cómo lo arranca y en qué consiste realmente instalar un SO.

jueves, 9 de mayo de 2013

Tu computadora y tú: la BIOS

Entendiendo la BIOS

En anteriores entradas he descrito muy someramente el proceso de arranque de un computador. He dicho que un programa especial, denominado BIOS (Basic Input-Output System) , o más modernamente EFI/UEFI, es el que se encarga de poner en marcha el computador y de comenzar la ejecución del Sistema Operativo. Hoy toca un pequeño artículo sobre esta aplicación y su principal uso: arrancar desde un dispositivo distinto.

Aunque hay proyectos para proporcionar esta aplicación de forma más o menos estándar y abierta, lo cierto es que cada fabricante usa su propia BIOS. O más exactamente, usa una de las más extendidas, principalmente American Megatrends o bien Phoenix Technologies. Por su parte, EFI es una especificación de Intel diseñada para reemplazar la BIOS.

mensaje de error cargando el microprocesador
La BIOS se encarga de detectar el hardware principal que utiliza nuestro computador: chequea la memoria (cantidad y estado), detecta los discos duros disponibles, el teclado, el microprocesador... Si alguno de los componentes falla o no está disponible, puede mostrar un mensaje de error en pantalla o incluso utilizar una convención de señales (por ejemplo, un número de pitidos) para avisar de tal error (por ejemplo, si no detecta tarjeta de vídeo o memoria). Muchas BIOS permiten configurar cómo se realiza este chequeo y qué se hace si hay error. Por ejemplo, podríamos desear que el computador arrancase sin teclado, ya que se va a acceder siempre a través de la red de la oficina.

 Una función interesante es la de establecer la hora del sistema: sí, la BIOS permite configurar el reloj interno del sistema, que será el que proporcione la hora a nuestras aplicaciones a través del Sistema Operativo.

Hay muchas funciones del computador que pueden necesitar ser configuradas en la BIOS. Hace unos días me comentaban el caso de unos equipos que precisaban que en BIOS se configurase la posibilidad de virtualizar sistemas operativos (e incluso equipos donde el usuario tenía que hackear la BIOS para poder hacerlo). Entre otras cosas, puede establecer el protocolo para comunicar los discos con el procesador, el sistema de ahorro de energía, y el orden de los dispositivos en el que buscar un sistema para arrancar.

Para acceder a la BIOS hay que pulsar alguna tecla cuando aparece la primera pantalla. Puede ser suprimir (tecla que pone "supr" o bien "del"), F1, Escape (ESC)... cada modelo de computador puede tener una distinta. Lo normal es que la primera pantalla nos diga cuál es, pero puede que pase tan rápido que no alcancemos a verlo. Así que si no tenemos el manual de la placa base o alguno de los que venía con el computador, lo que podemos hacer es buscarlo (digamos con Google). Por ejemplo, para buscar la tecla que corresponde a un HP G56 buscamos

 hp g56 tecla acceso bios

con lo que Google nos mostrará una lista de resultados, el primero de los cuáles nos sirve perfectamente. De forma similar, para un Sony Vaio podemos bucar algo como

Sony Vaio tecla acceso bios

En los portátiles es común disponer de alguna suerte de "menú" de opciones (arrancar en otro dispositivo, entrar en la aplicación BIOS, etc.), aunque otros simplemente tienen asignadas distintas teclas a las distintas posibilidad (F2 para arrancar en otros dispositivos, F10 para entrar en la BIOS...).

Unas palabras sobre EFI

Aunque el sistema EFI permite arrancar desde DVD, USB y demás, lo cierto es que la forma en la que carga el arranque del disco duro es muy diferente a lo que hace la BIOS.  En lugar de cargar el sector de arranque del disco duro, lo que hace es cargar un sistema de arranque situado en una partición especial, de un tipo a la sazón llamado "tipo EFI". Decir que esta partición debe de utilizar un (primitivo) sistema de ficheros FAT para funcionar. En equipos que tengan EFI/UEFI, para arrancar otros sistemas instalados en otras particiones, es necesario modificar dicho sistema de arranque para que tenga la opción de arrancar en dicho sistema. No hace mucho esto era una tarea que debía realizarse a mano, pero hoy cada vez más sistemas (diferentes a Windows) son capaces de instalarse en un computador con EFI/UEFI sin mayores molestias para los usuarios.

Cosa distinta es el "Secure Boot", el enésimo engendro de Microsoft para tratar de mantener el mismo mercado cautivo. Algunos sistemas soportan esta característica, aunque lo recomendable en todo caso es deshabilitarla al menos mientras se instala tal sistema.

miércoles, 1 de mayo de 2013

Tu computadora y tú: funcionamiento básico

En las dos entregas anteriores he tratado de describir algunos conceptos básicos para entender cómo funciona un computador. Hasta ahora ha sido una descripción vuela pluma de tales conceptos, para familiarizar a los no entendidos con ellos.

Hoy toca profundizar un poco en algunas de tales ideas. Comenzaremos con una mejor descripción de la arquitectura del sistema, hablaremos de los discos duros y su uso, y finalizaremos la entrega con una descripción básica del arranque del sistema.

Arquitectura

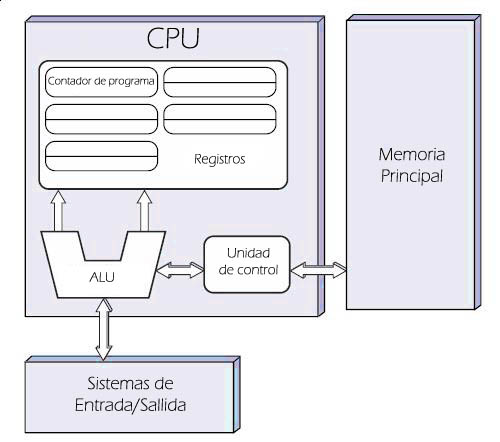
En el primer capítulo describí la arquitectura básica de forma muy somera. Ahora toca mejorar eso. En la imagen de la derecha hay una de las representaciones gráficas habituales (cortesía de wikipedia, donde puedes leer un buen artículo sobre el tema). El cuadrado grande es la Unidad Central de Proceso,  (UCP) que se compone de la Unidad Aritmético-Lógica (UAL) -que realiza operaciones aritméticas o lógicas, como cabría esperar- y la Unidad de Control (UC). También incluye una serie de registros donde guarda información necesaria para el funcionmiento del sistema.

A la derecha está la Memoria Principal, mientras que abajo está el Sistema de Entrada-Salida.

Cuando estás en una escuela informática, suelen contarte la historia completa en la misma asignatura además de en otras; sin embargo, lo cierto es que estas representaciones despistan: cualquier información -datos, programas- a usar debe de estar cargada en memoria principal. Por supuesto, es la UCP la que se encarga de acceder a un disco duro y de transferirlo a la Memoria Principal, y por ello se representa la doble flecha entre la UAL (ALU, en inglés) y los sistemas de Entrada/Salida.

Por cierto, algo "entra" cuando se recibe en la UCP, mientras que algo "sale" cuando desde la UCP es enviado a algún lado (impresión, para ser guardado en disco, etc.).

Una consecuencia es que un informático (y ahora cualquier lector) que lea un anuncio de una compañía telefónica de comienzos de 2013 y lea algo como "(tal móvil)... con 32 GB de memoria..." debería de sufrir dentera ante tamaña estupidez. En ocasiones, los discos duros y otros discos son denominados "memoria secundaria", pero eso no justifica que se sumen las capacidades de una (la principal) y otra (los discos). Para extender el uso de las memorias en los sistemas informáticos, puedes echar un vistazo a la wikipedia, comenzando por el interesante problema de la jerarquía de memoria (o como resolver el problema del coste de las memorias).

Discos Duros

Los discos duros son el componente de almacenamiento secundario más utilizado de los últimos 50 años, y aunque las tabletas y smartphones suelen equipar tarjetas flash por su menor consumo, lo cierto es que los discos duros serán aun los reyes de los computadores durante unos cuantos años. El artículo de la wikipedia sobre discos duros es mucho más ambicioso de la breve explicación que aquí se va a dar.

La clásica explicación comienza con el disco de vinilo (esto es, se asume que el aprendiz ha visto uno, cosa que para las nuevas generaciones no habría por qué esperar). Uno pone un disco en el tocadiscos, coloca la aguja al principio y el dico comienza a girar. El tocadiscos va reproduciendo lo que lee la aguja a medida que va pasando por el disco. Eventualmente, podemos saltar una pista o una parte (de forma muy aproximada, a ojo) levantando la aguja y acercándola o alejándola del centro. Podemos reproducir una cara y darle la vuelta y reproducir la otra cara.

Un disco duro es un dispositivo rígido (hard) que va dentro del computador. Por supuesto, no se le da la vuelta ni nada similar. En realidad es mucho más eficiente que cualquier fonógrafo de tres al cuarto.

En primer lugar, gira muchísimo más rápido. Un tocadiscos normal puede girar a 33 o 55 revoluciones por minuto (rpm); un disco duro barato de un portátil girará 5400 rpm, y los hay de 7200 ¡y hasta de 11000!!

En segundo lugar, tiene dos caras (esto sí como el tocadiscos) y suelen ser varios platos (cada disco de dos caras es un plato, también es común llamar así al disco de vinilo), entre 2 y 4, pero con modelos que tienen 6 o 7. El brazo del lector se compone en realidad de un brazo doble por cada plato (uno por cada disco, y doble para leer tanto la parte superior como inferior a la vez), con sus respectivos lectores.

Representación de los cilindros de un disco
Pero para que esto sea útil se necesita que la información se guarde de la forma adecuada. Lo que se hace es agrupar la información para que pueda ser leída por cada lector de cada brazo a la vez: es lo que se llama cilindro: la representación de lo que un lector puede leer en cada parte de cada disco en un giro.

En la imagen de la izquieda puede verse la representación de esto. La pista, por su parte, es la circunferencia en cada cara de cada disco. Los sectores son las partes en las que se divide cada pista.


Los Sistemas Operativos se encargan de proporcionar un acceso uniforme a los discos, y es habitual representarlos con un rectángulo desde el principio hasta el final, ya sea indicando los sectores o la capacidad.

Los discos duros se utilizan divididos en Particiones (modernamente llamadas también volúmenes, aunque en la práctica son cosas distintas, de las añadiré un artículo otro día). Particionar no existe según la RAE, y en el mundo informático se usa para denominar al proceso de crear particiones en un disco. Lo más probable es que se comenzara a particonar los discos porque las BIOS de entonces no podían acceder al contenido de todo el disco: imagina que tienes 100.000 sectores y que la BIOS sólo sabe contar desde 0 hasta 65535, es decir, que en este caso ¡sólo tiene 16 bits para guardar una dirección de disco!!

Sin embargo, particionar un disco resultó ser útil, ya que los cambios en una partición no afectan a las demás particiones del sistema. Ojo: siempre tiene que haber al menos una partición.

El sistema "tradicional" es la "tabla de partición MS-DOS" por ser la que se utilizaba en tal Sistema Operativo. Es una pequeña tabla que admite cuatro entradas, una para cada partición, en las que se indican sus respectivos principios y finales. Posteriormente se añadión una "extensión" para solventar este límite numérico. En lugar de cuatro particiones (llamadas ahora "primarias") se pueden crear tres particiones normales (primarias) y una "especial" llamada a la sazón "extendida". En estas particiones, lo que se hace es que se pueden crear particiones (llamadas ,para distinguirlas de las normales, lógicas) a condición de que cada una incluya donde comienza la siguiente.

Este mecanismo un poco chapuza es el más habitual aun hoy, aunque ya se utiliza cada vez más otro mecanismo: la GPT, que permite crear un montón de particiones normales en cada disco. Así desaparece la tradicional distinción entre partición primaria y partición lógica (no necesita particiones extendidas).

Otro concepto asociado al uso de discos duros es el de Formateo, aunque este nombre es más utilizado por la herramienta tradicional de MS-DOS para esta operación que por ser un nombre adecuado. En el mundo Unix se habla más bien de "crear sistemas de ficheros", lo que es más descriptivo y coherente.

Eso quiere decir que una partición de disco no es más que un trozo de superficie magnética donde puedes eventualmente guardar cosas. Si guardas varios ficheros, el Sistema Operativo necesitará alguna forma de saber dónde se guarda cada uno de ellos -además de algunas características como la fecha de modificación, permisos, etc.-; también es un servicio que se proporciona a los usuarios del SO, tanto humanos como a las aplicaciones del sistema. Tú guardas un documento en Documentos/trabajos/aprender_informática.txt, no entre los sectores 47567 y 47579. Es lo que se denomina Sistema de archivos. Uno de los más simples es FAT, que consiste simplemente en una lista de nombres de ficheros y su localización en el disco. Además de haberlo tratado en el artículo anterior, el artículo de la wikipedia es bastante razonable y no lo voy a replicar aquí.

Arrancando la máquina

Los computadores proporcionan una aplicación grabada en una memoria ROM que permite ejecutar algún Sistema Operativo. Básicamente se encarga de comprobar que las principales cosas funcionan -p.ej, memoria, discos...- y de ejecutar la aplicación que cargue el sistema de arranque del SO en memoria. Hecho esto, comienza la ejecución del Sistema Operativo en sí misma.

Las Computadoras Personales (PC) solían traer una aplicación denominada BIOS (Basic In/out System, Sistema Básico de Entrada/Salida, otro nombre descriptivo), que hacía justamente eso: comprobaba que había un procesador, una memoria y algún dispositivo de entrada/salida: al menos un teclado, al menos un disco duro...

Hay un sector del disco duro denominado (de forma, también, apropiada) MBR (Master Boot Record, Registro Principal de Arranque) que es el primer sector del disco duro y que queda fuera de las particiones. En dicho registro se guarda la Tabla de particiones antes comentada y el programa que se encargará del arranque. En muchos computadores, esto consiste en una serie de instrucciones básicas para que el computador cargue el primer sector (también llamado, sector de arranque) de alguna partición, que eventualmente será, vaya, el sistema de arranque del Sistema Operativo.

Así que el último paso ejecutado por la BIOS es cargar en memoria el contenido del MBR.

Hoy las BIOS van siendo sustituidas por un nuevo sistema: EFI. Tal sistema pretende solventar algunas de las limitaciones de las BIOS, pero en realidad su tarea es la misma: comprobar los componentes principales, y cargar en memoria el arranque del Sistema Operativo o el Cargador de Arranque de turno.

En los sistemas EFI se puede indicar directamente qué se desea arrancar, sin necesidad de MBR; de todas formas, y por las dudas, EFI también permite usar MBR en lo que ellos llaman "modo híbrido".

También volveré sobre el arranque del sistema, que como he dicho merece su propia entrada.

martes, 30 de abril de 2013

Ponencia: Afinando sistemas. Primeras conclusiones

Ayer he ido a presenciar una ponencia sobre el ajuste (afinamiento, tuning) de sistemas. Impartida por Fernando Ruiz-Tapiador (uno de los pocos "Arquitectos Certificados Red Hat" de España), en el Centro de Novas Tecnoloxías de Galicia (CNTG); naturalmente se centraba en los sistemas Red Hat, si bien como es de esperar el 99% de lo dicho es aplicable a cualquier sistema GNU/Linux.

Una ponencia de cuatro horas sobre este tema es, reconozcámoslo de entrada, bastante dura. Ni siquiera la pericia (o experiencia) de Fernando puede evitar esto. Aunque, como es de esperar, fue una ponencia en la que se pudieron aprender algunas cosas, y como es habitual en las clases impartidas por Fernando, algún truquillo tan útil como muchas veces desconocido.


No voy a hacer una entrada exhaustiva sobre la ponencia. Fernando se comprometió a colgar el pdf de la presentación independientemente de que el CNTG hiciese lo propio. Si para entonces tengo tiempo y ánimo, intentaré hacer un resumen de cosas útiles. Hoy sólo quiero dejar aquí un par de cosillas interesantes.

En primer lugar, GNU/Linux es un sistema muy maduro, basado en otro sistema también muy maduro: tiene muchos desarrolladores y muchísima gente que lo utiliza, por lo que está muy bien afinado per se. Eso implica que, salvo en casos muy concretos, para afinar una cosa hay que desafinar otra. Por otra parte, debe tenerse en cuenta que cualquier cambio que se haga puede tener consecuencias imprevistas.

La primera recomendación es la obvia: deshabilita (incluso desinstala) cualquier cosa que no uses. Otra buena recomendación es estimar si realmente necesitas afinar el sistema.

¡Vaya!! ¿es malo que un procesador tenga una carga de trabajo del 90%? ¡Pues para eso lo compraste!! También es importante ver la relación esfuerzo/impacto del afinamiento que queramos realizar. Un ejemplo sencillo es el arranque de los sistemas servidores de producción: son sistemas pensados para ser arrancados muy pocas veces, por lo que una demora de 10 o 20 segundos en su arranque no suele merecer mucho esfuerzo por parte de sus administradores.

En segundo lugar, para saber si es preciso (o incluso posible) el ajuste del sistema, se deben de utilizar datos fiables, no suposiciones. Esto incluye que normalmente el usuario tiene una impresión del rendimiento del sistema muy ligada a la interactividad del mismo. Sí, el usuario tiende a creer que un sistema es más rápido si le responde rápidamente a él, independientemente de cuánto tiempo real tarden las cosas en realizarse.

Por supuesto, para estudiar el rendimiento real de un sistema deberemos hacerlo en función de las tareas reales a realizarse con él. Y también es cierto que eso suele llevar tiempo. Y otro factor importante es que realizar tales mediciones tenderá a influir en el rendimiento real del sistema, con lo que deberá discriminarse la parte de sobrecarga debida a nuestro estudio.

Es frecuente encontrar "reglas" para "afinar" un sistema o para mejorar el rendimiento del mismo. La lectora avisada habrá pensado que, en el mejor de los casos, que tales ajustes sirvan de algo es algo posible, pero no demasiado probable. No es fácil.

Un ejemplo de documentación sobre este tema puede ser la System Analysis and Tuning Guide (en este caso, para openSUSE, que es mi Sistema Operativo principal). Y si bien es cierto que sí hay unas cuantas reglas generales que se pueden utilizar, también es cierto que el usuario debe cerciorarse completamente de que ese cambio no va a producir consecuencias imprevistas, como he dicho antes. Piénsese que si un cambio pudiese ser útil siempre, con seguridad el sistema ya vendría con él incorporado.

Salud y feliz computación!!